今日概览
从本次候选数据 97 条中选出 8 条:AI/AIGC 4 条、社会学/哲学 1 条、交易/宏观 3 条。
评分由规则计算,不是模型对文章真实性的判定。以下“原文事实”仅指来源明确陈述的内容,并不代表独立核验;“作者观点”与“AI 分析”分别标注。材料不足时明确说明限制,不补写事实。
AI 今日观察:本期材料呈现出几组值得追问的关系:政策讨论如何转为可研究的数据,计算结果如何获得可验证的依据,以及技术能力、教学目标和组织执行如何接受检验。这是AI的综合观察。多数条目仅有 RSS 摘要,能够确认的是研究方向或来源主张,尚不足以判断方法效果;Simon Willison 条目提供了提取正文,但其中企业数据、作者评论和工程师解释仍需分别归因。
精选资讯
用大语言模型研究货币政策委员会的讨论叙事
领域:交易/宏观|来源:Bank Underground|评分:82.18/100|材料:仅依据 RSS 摘要|置信度:低(摘要)
原文事实(来源陈述):仅依据 RSS 摘要:来源称,Dragos Gorduza、Livia Silva Paranhos 和 Ivan Yotzov 使用大语言模型分析英国央行货币政策委员会在 2015 至 2017 年的会议逐字稿,并提取委员个人对通胀和增长看法的结构化度量。以上是来源陈述,未经独立验证;摘要关于叙事的后续说明被截断。
作者观点:摘要中的作者认为,货币政策决定反映了新收到的数据、预测和政策制定者偏好。材料未展示他们对分析结果的具体解释,也不足以将其观点视为英国央行立场。
AI 分析:AI推断:把政策讨论转为结构化指标,可能帮助研究同一决策背后的不同判断。当前摘要没有提供指标定义、模型误差或验证结果,因此不能据此判断模型是否准确识别了委员偏好,更不能推出政策预测或交易结论。
Magnetar:面向通用计算的证明方法
领域:AI/AIGC|来源:Microsoft Research|评分:80.2/100|材料:仅依据 RSS 摘要|置信度:低(摘要)
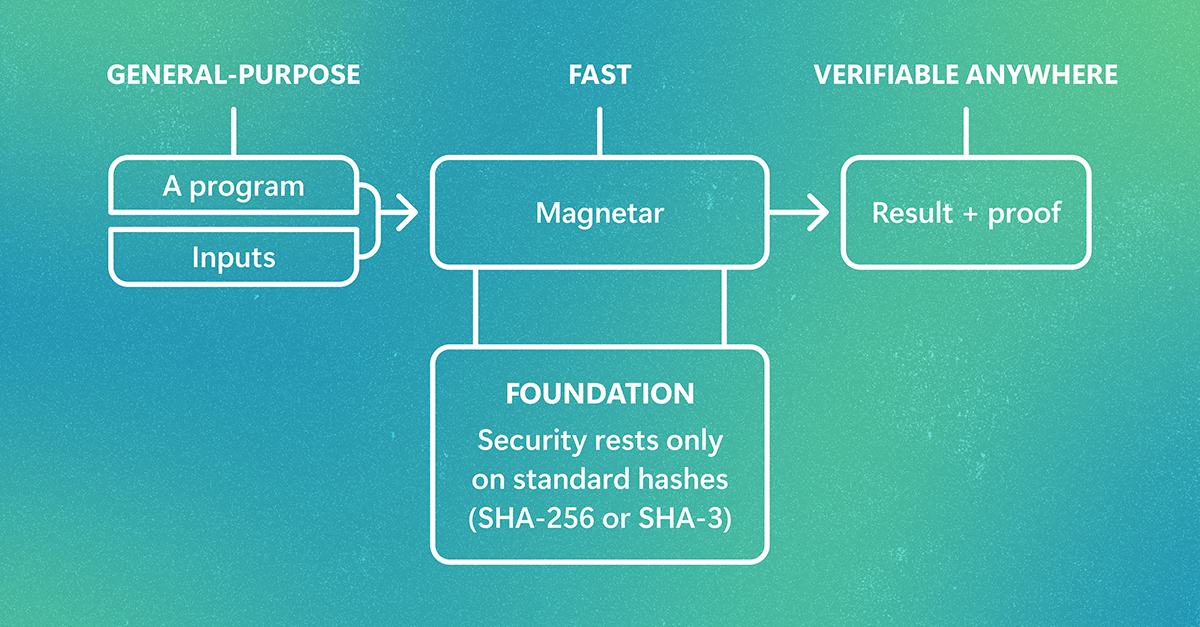
原文事实(来源陈述):仅依据 RSS 摘要:Microsoft Research 博客称,零知识证明可以在不重新运行工作负载或暴露敏感数据的情况下验证计算结果,并称 Magnetar 支持标准编程语言、显著提速及抗量子安全。以上均为来源陈述,未经独立验证;摘要没有给出性能数据或安全条件。
作者观点:摘要将 Magnetar 描述为推动零知识证明进入主流应用的工具。这是博客摘要的评价;材料没有明确个人作者,也不足以将其扩展为微软整体立场。
AI 分析:AI分析:值得研究的是证明生成与结果验证分别需要多少资源,以及这些成本是否适合目标工作负载。摘要中的提速和安全表述缺少比较基准与适用条件,不能直接转化为部署建议。
新访谈系列探讨为何教授哲学
领域:社会学/哲学|来源:Daily Nous|评分:74.4/100|材料:仅依据 RSS 摘要|置信度:低(摘要)
原文事实(来源陈述):仅依据 RSS 摘要:Daily Nous 介绍了名为《为何教授哲学》的新访谈系列,受访者是以教学、哲学教学法研究或课程设计工作见长的哲学学者。这是来源陈述,未经独立验证;摘要没有提供访谈内容。
作者观点:摘要没有可识别的作者论点,也没有受访者对为何教授哲学的具体回答。系列名称本身不能作为任何人的观点。
AI 分析:AI分析:这一选题可以从教学实践、教学法研究和课程设计之间的联系展开。当前只能确认访谈对象的遴选方向,不能据此总结哲学教育的价值或受访者共识。
计算方法研究细胞如何沟通并形成组织
领域:AI/AIGC|来源:MIT News AI|评分:74.04/100|材料:仅依据 RSS 摘要|置信度:低(摘要)
原文事实(来源陈述):仅依据 RSS 摘要:MIT News 称,一种新的计算方法揭示了细胞如何沟通并组装成组织。这是来源陈述,未经独立验证;摘要没有提供方法、实验或性能细节。
作者观点:摘要提出,这项方法可能加快干细胞工程、改善疾病模型并为治疗提供参考。这是来源对潜在用途的判断,不能视为这些效果已经实现;个人作者及研究者原话未提供。
AI 分析:AI分析:需要核验模型输出与实验观察如何对应,以及潜在用途是否获得独立验证。现有摘要不足以判断该方法能否支持干预设计或实际治疗。
SONIA 利益相关方咨询小组的职责说明
领域:交易/宏观|来源:Bank of England|评分:73.01/100|材料:仅依据 RSS 摘要|置信度:低(摘要)
原文事实(来源陈述):仅依据 RSS 摘要:来源称,SONIA 利益相关方咨询小组通过向英国央行及 SONIA 监督委员会提供建议和技术意见,支持英国央行管理 SONIA。这是来源陈述,未经独立验证;摘要没有披露具体会议讨论或决定。
作者观点:摘要属于小组职责说明,没有可识别的个人观点,也未呈现与会者立场或政策判断。
AI 分析:AI分析:材料可用于识别咨询与监督安排,但不足以推断本次会议是否改变了任何管理规则。研究会议影响仍需具体议程、讨论内容和决定记录。
生活成本与工资:比较不同消费价格指标
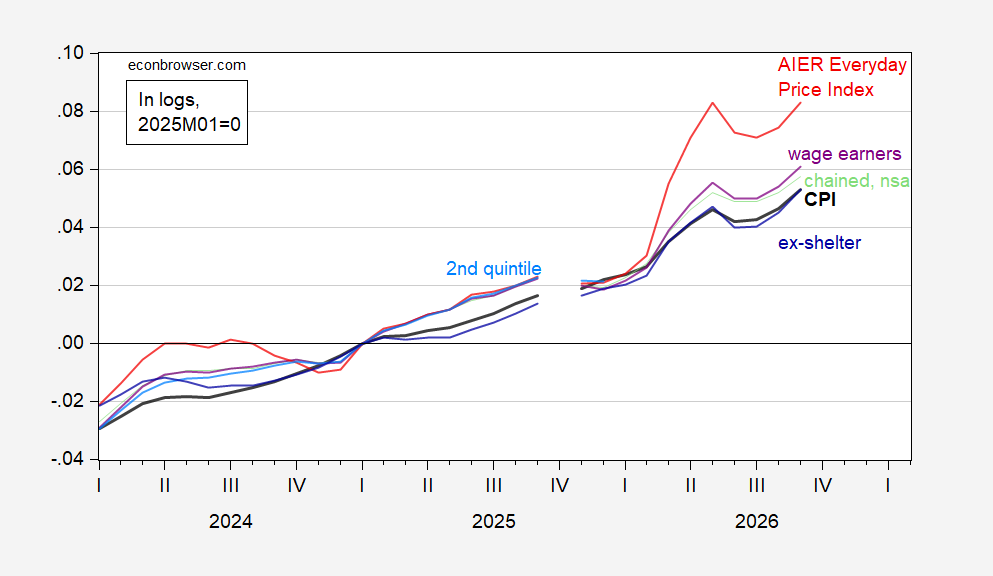
领域:交易/宏观|来源:Econbrowser|评分:71.03/100|材料:仅依据 RSS 摘要|置信度:低(摘要)
原文事实(来源陈述):仅依据 RSS 摘要:来源列出 CPI – all urban、CPI wage earners and clerical workers、chained CPI、CPI ex-shelter 和 AIER Everyday Price Index,称图中均采用对数形式、基准为 2025M01=0,并标注 BLS、AIER 及作者计算为数据来源。这是来源陈述,未经独立验证;材料没有展示图形数值或工资数据。
作者观点:摘要末尾提出日常开支是否比 CPI 上涨更快的问题,但句子被截断,无法识别作者的完整判断或解释。
AI 分析:AI分析:不同价格指标的比较可作为研究生活成本感受的入口。没有完整图表、指标定义及工资数据,不能判断哪个指标涨得更快,也不能推断实际工资变化。
Simon Willison 评论 Anthropic 的源码管理系统重构
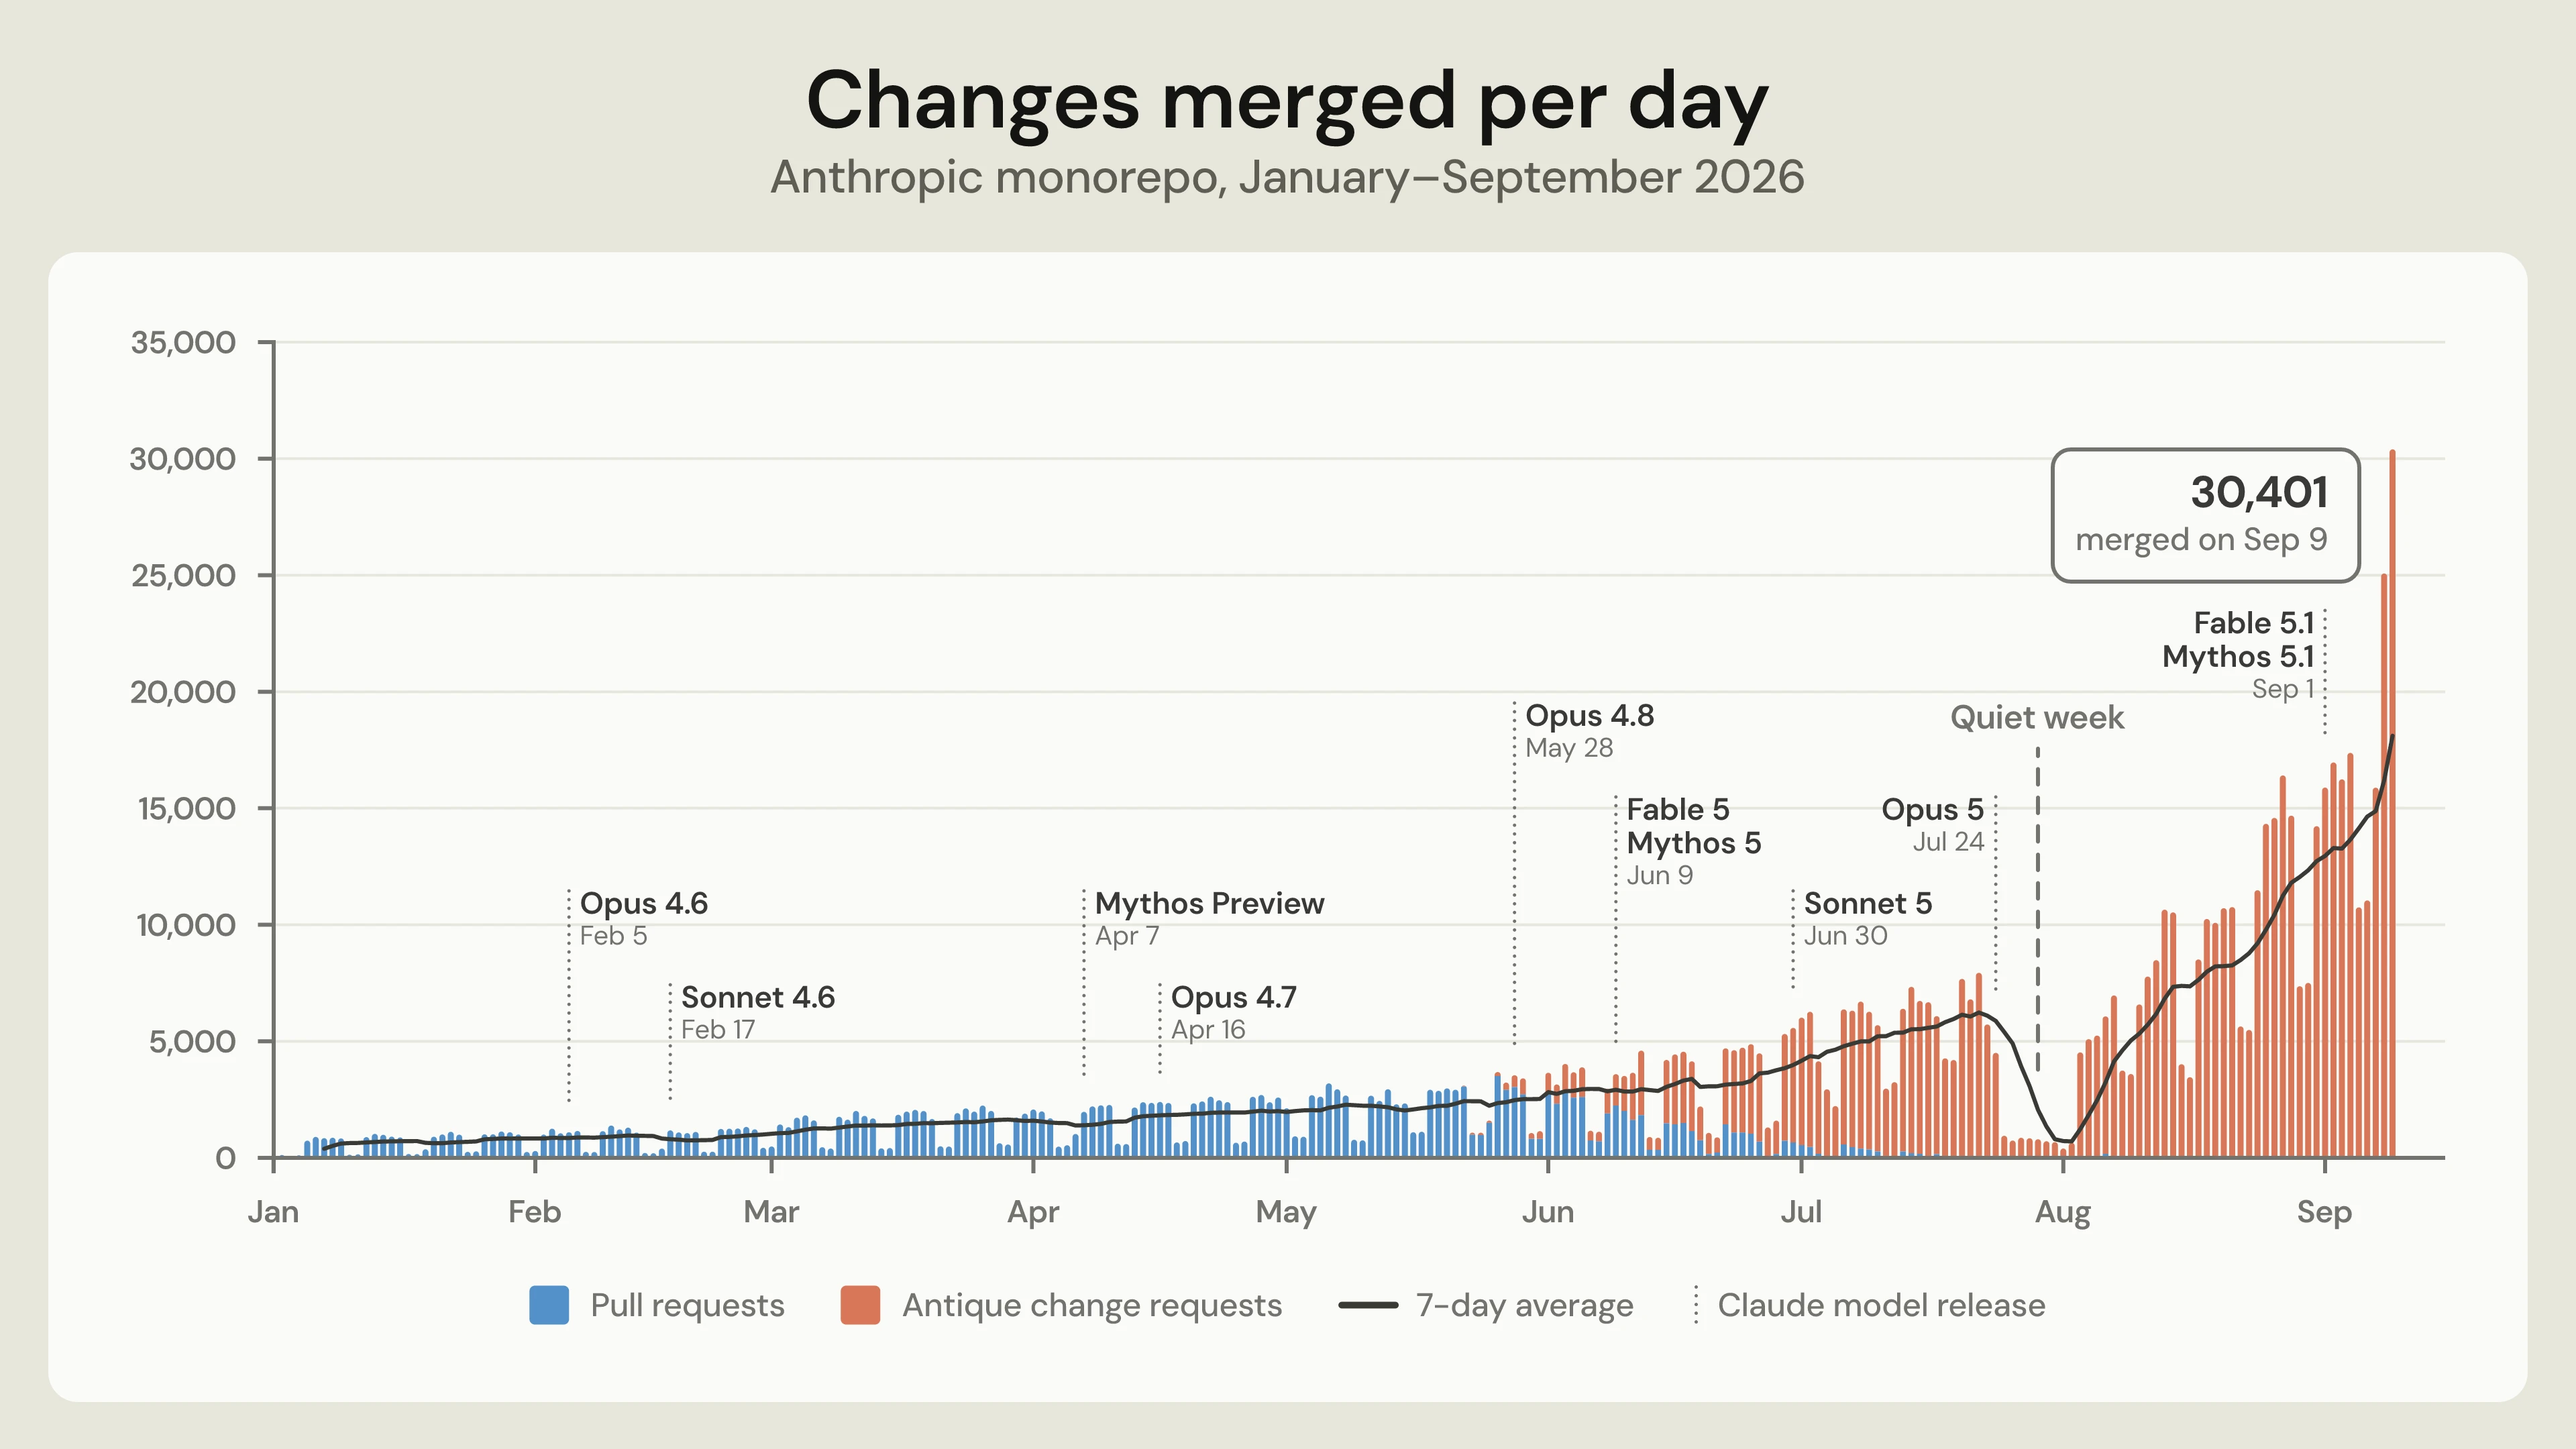
领域:AI/AIGC|来源:Simon Willison|评分:70.91/100|材料:已读取正文(自动提取,完整性未独立确认)|置信度:中等(正文未独立事实核查)
原文事实(来源陈述):依据自动提取正文:Simon Willison 转述 Anthropic 文章称,其每日合并代码变更由 May 2026 的约 2,500 增至 September 的超过 30,000;新源码管理系统名为 Scion,代码审查系统名为 Antique。上述属于正文转述,未经独立验证,也未核验被链接原文。正文还将离线支持不被优先考虑的解释明确归于 Scion 工程师 Nick G:Claude 是最主要的使用者且必须在线。提取正文的完整性尚未独立核验。
作者观点:Willison 猜测 Fable/Mythos 类模型是编码速度增长的重要因素,同时明确图中标记的是公开发布日期,并非内部可用日期。他认为 Scion 类似集中式源码管理,并表示文中关于对抗式审查可能局限于狭窄视角的描述呼应了自身经验。这些是 Willison 的评论或猜测,不是 Anthropic 已证实的因果结论。
AI 分析:AI分析:这篇链接博客可作为研究代码变更规模与开发基础设施关系的线索。公开模型发布日期与变更量的并列展示不能确立因果,合并次数也不足以衡量质量或整体生产率。企业数据、Willison 的解释及 Nick G 的发言应保持独立归因。
供应链可持续性:承诺与执行之间的治理缺口
领域:AI/AIGC|来源:MIT News AI|评分:70.49/100|材料:仅依据 RSS 摘要|置信度:低(摘要)
原文事实(来源陈述):仅依据 RSS 摘要:来源称,MIT 运输与物流中心发现,可持续性承诺较强,但治理缺口和外部扰动阻碍执行。这是来源对研究发现的概括,未经独立验证;摘要没有提供样本、指标或分析方法。
作者观点:摘要将治理缺口和外部扰动列为执行障碍,但没有可识别个人作者的进一步观点,也没有呈现研究者的完整论证。
AI 分析:AI分析:可将企业承诺如何转化为执行作为研究问题,重点核验承诺与执行的衡量方式,以及障碍判断的证据。现有摘要不足以确定各因素的影响大小或独立因果作用。
深度分析
用大语言模型研究货币政策委员会的讨论叙事
分析依据:仅依据 RSS 摘要;尚未读取正文|置信度:低(摘要)
原文事实:仅依据 RSS 摘要:研究对象是英国央行货币政策委员会在 2015 至 2017 年的会议逐字稿,工具是大语言模型,摘要明确提到的输出包括个人对通胀和增长看法的结构化度量。来源没有在现有材料中展示样本构成、提取规则、结果或验证方法。正文尚未读取,以上仅为摘要陈述。
作者观点:作者以数据、预测和政策制定者偏好共同反映于政策决定作为研究出发点,并尝试从会议语言中提取个人判断。摘要不足以确认他们如何区分观点、叙事与最终决策,也没有呈现明确的实证结论。
AI 分析:AI分析:这项研究方向的价值,在于尝试把会议讨论中难以直接比较的语言变成可检验的研究对象。但结构化输出是否可靠,取决于模型能否区分发言者自己的判断、对他人观点的转述,以及讨论中的假设情境。现有摘要没有说明这些处理规则,也没有提供人工标注对照或模型稳定性证据。后续研究可重点核验:相同文本在不同提示下是否得到一致度量,委员观点是否保留不确定性,以及指标与最终决策之间的关系如何解释。即使二者存在关联,也不能直接认定叙事导致了决策变化。当前可讨论的是研究设计的潜力,尚不能评价实际识别效果。
Magnetar:面向通用计算的证明方法
分析依据:仅依据 RSS 摘要;尚未读取正文|置信度:低(摘要)
原文事实:仅依据 RSS 摘要:来源介绍了零知识证明验证计算结果的用途,并为 Magnetar 列出标准编程语言支持、速度提升和抗量子安全等特征。现有材料没有说明支持哪些语言、测试了哪些任务、如何比较速度,也没有提供安全论证。正文尚未读取,各项能力仅能按来源主张记录。
作者观点:博客摘要认为,Magnetar 的语言支持、性能和安全特征有助于零知识证明走向主流。摘要未解释主流应用的判断标准,也没有提供可识别个人作者的进一步论证。
AI 分析:AI分析:这条材料的研究价值在于把计算正确性的验证与实际工程成本放到同一问题中。要判断其应用空间,需要核验所谓速度提升对应证明生成、验证还是完整流程,以及比较对象和任务条件是否一致。支持标准编程语言也需要进一步明确支持范围、限制和接入工作量,不能仅凭摘要理解为任意程序均可直接使用。抗量子安全的表述则需要结合具体方案、假设与实现边界审视。现有材料没有这些证据,因此只能提出评估框架,不能确认性能优势或安全保证。后续最有价值的工作,是把摘要中的能力宣称逐项对应到可复现测试与明确的安全论证。
新访谈系列探讨为何教授哲学
分析依据:仅依据 RSS 摘要;尚未读取正文|置信度:低(摘要)
原文事实:仅依据 RSS 摘要:材料介绍的是一个新的哲学访谈系列,并列出受访者相关的教学、哲学教学法研究和课程设计工作。摘要没有列出受访者姓名、问答、课程案例或教学效果证据。正文尚未读取,能够确认的内容仅限来源对系列及受访者方向的介绍。
作者观点:现有材料没有展示文章作者对哲学教育的判断,也没有展示受访哲学学者的立场。不能从提问主题推导其答案,更不能把系列介绍写成教育价值的论证。
AI 分析:AI分析:这个系列的潜在研究价值,在于让哲学教育的目标与具体教学安排接受共同审视。后续可以考察受访者如何界定教学目标、如何选择课程内容,以及如何判断学生是否获得了预期能力。但目前只有系列介绍,无法确认访谈是否实际涉及这些问题。受访者因教学、教学法研究或课程设计而入选,也不能单独证明其方法有效或适用于其他课堂。若用于创作,应围绕这些尚待回答的问题组织文章,并在获得访谈正文后区分个人经验、规范性主张和效果证据。当前材料能够支撑的是选题框架,不能支撑关于哲学教育成效的综合结论。